ความลับที่ซ่อนอยู่ในสถิติ:
อักษรวอยนิชคือภาษาลับ หรือเป็นเพียงเกมลูกเต๋าจำลอง?
ตลอดเวลากว่าหนึ่งศตวรรษที่ผ่านมา "ต้นฉบับวอยนิช" (The Voynich Manuscript) ถูกยกย่องให้เป็นสมุดบันทึกโบราณที่ลึกลับที่สุดในโลก มันถูกเขียนขึ้นด้วยอักขระที่ไม่มีใครอ่านออก ประกอบกับภาพวาดพืชพันธุ์ประหลาด แผนภูมิจักรราศีที่ไม่ตรงกับดวงดาวบนท้องฟ้าจริง และสตรีเปลือยในอ่างน้ำสีเขียวที่เชื่อมโยงด้วยท่อของเหลวพิสดาร นักถอดรหัสระดับตำนานของกองทัพสหรัฐฯ ในช่วงสงครามโลกครั้งที่สอง ไปจนถึงผู้เชี่ยวชาญด้านภาษาศาสตร์คอมพิวเตอร์ระดับโลก ต่างพยายามไขความหมายของหนังสือเล่มนี้ ทว่าจนถึงปัจจุบัน... ยังไม่มีใครแปลมันได้แม้แต่ประโยคเดียว
แต่ถ้าหากเราเปลี่ยนมุมมองใหม่ โดยไม่มองหนังสือเล่มนี้ผ่านเลนส์ของ ภาษาศาสตร์ แต่พิจารณาผ่านเลนส์ของ คณิตศาสตร์ความน่าจะเป็น สถิติศาสตร์ และจิตวิทยาการรู้คิด (Cognitive Science) เราอาจค้นพบความจริงที่น่าตกตะลึงยิ่งกว่า: ความลี้ลับนี้อาจไม่ได้เกิดจากภูมิปัญญาอันล้ำลึกของมนุษย์ หรือสูตรลับเล่นแร่แปรธาตุที่สาบสูญ แต่เกิดจาก "กลไกการสุ่มเชิงสถิติ" (Statistical Randomness) ที่เรียบง่ายประหนึ่งการทอยลูกเต๋า ซึ่งถูกวิวัฒนาการต่อมาจนกลายเป็นกลไกหลักของ โมเดลภาษาปัญญาประดิษฐ์ (Large Language Models) ในปัจจุบัน!
1 ต้นฉบับวอยนิชและจิตวิทยาแห่งการตีความ (The Manuscript & Cognitive Bias)
1.1 วัตถุโบราณอายุ 600 ปี (Yale Beinecke MS 408)
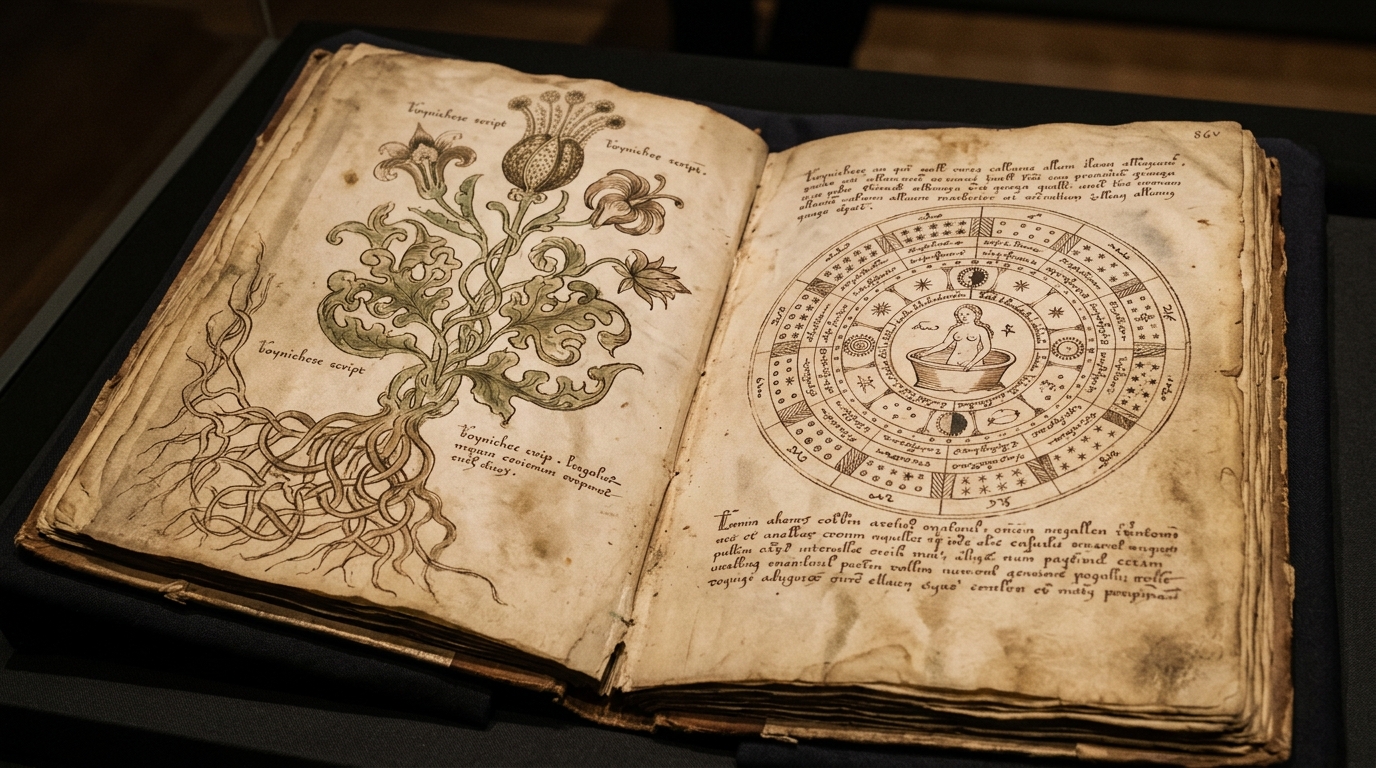
สมุดบันทึกเล่มนี้ถูกค้นพบในปี ค.ศ. 1912 โดย วิลฟรีด วอยนิช (Wilfrid Voynich) พ่อค้าหนังสือเก่าชาวโปแลนด์ ณ วิทยาลัยเยซูอิตในประเทศอิตาลี ปัจจุบันถูกเก็บรักษาไว้อย่างเข้มงวด ณ หอสมุดหนังสือหายากและต้นฉบับเบเนเก (Beinecke Rare Book & Manuscript Library) มหาวิทยาลัยเยล ภายใต้รหัส MS 408
ผลการตรวจหาอายุด้วยการวัดคาร์บอนกัมมันตรังสี (Radiocarbon Dating - $^{14}\text{C}$) โดยมหาวิทยาลัยแอริโซนา ยืนยันว่าแผ่นหนังลูกวัว (Vellum) ของหนังสือเล่มนี้ถูกผลิตขึ้นในช่วง ค.ศ. 1404 – 1438 ในยุคเรเนซองส์ตอนต้น มีจำนวนหน้าหลงเหลืออยู่ 240 หน้า เขียนด้วยหมึกน้ำดีของต้นโอ๊ก (Iron Gall Ink) และระบายสีด้วยแร่ธาตุธรรมชาติ ตัวหนังสือมีความลื่นไหลสม่ำเสมอ ไม่มีรอยลบ รอยขูดแก้ หรือการชะงักงันของหัวปากกาขนนก ซึ่งเป็นลักษณะที่ไม่ตรงกับการเขียน "รหัสลับ" (Ciphertext) ทั่วไป ที่ผู้เขียนมักต้องหยุดคิดเพื่อเทียบตารางรหัสตลอดเวลา
1.2 สถิติภาษาศาสตร์ที่แปลกประหลาด: เป็นภาษาจริงหรือภาพลวงตา?
สิ่งที่ทำให้นักภาษาศาสตร์งุนงงที่สุด คือเมื่อนำข้อความในวอยนิช (ซึ่งมีประมาณ 35,000 คำ และชุดอักขระพื้นฐานประมาณ 20–25 ตัว) ไปวิเคราะห์ด้วยสถิติทางคณิตศาสตร์ กลับพบปรากฏการณ์ที่ขัดแย้งกันอย่างยิ่ง:
- กฎของซิปฟ์ (Zipf's Law): ความถี่ของคำแปรผกผันกับอันดับความถี่ ($f(r) \propto 1/r$) คำที่พบบ่อยที่สุดจะพบบ่อยกว่าคำอันดับ 2 สองเท่า เหมือนกับภาษาอังกฤษ ละติน และไทยทุกประการ
- ความยาวของคำ (Word Length): มีการแจกแจงแบบปกติ (Normal Distribution) โดยมีความยาวเฉลี่ยประมาณ 5–6 ตัวอักษรต่อคำ
- การซ้ำคำผิดธรรมชาติ (Word Reduplication): มีคำซ้ำกัน 2 หรือ 3 ครั้งติดกันบ่อยมาก เช่น qokedy qokedy dal ซึ่งแทบไม่เคยเกิดขึ้นในภาษายุโรป
- กฎตำแหน่งที่แข็งทื่อ (Rigid Morphology): อักษรบางตัวจะปรากฏเฉพาะต้นคำเท่านั้น อักษรบางตัวอยู่เฉพาะท้ายคำ และไม่มีโครงสร้างประโยคหรือเครื่องหมายวรรคตอนใดๆ เลย
1.3 จิตวิทยาแห่งการตีความ: ปรากฏการณ์อาโปฟีเนีย (Apophenia)
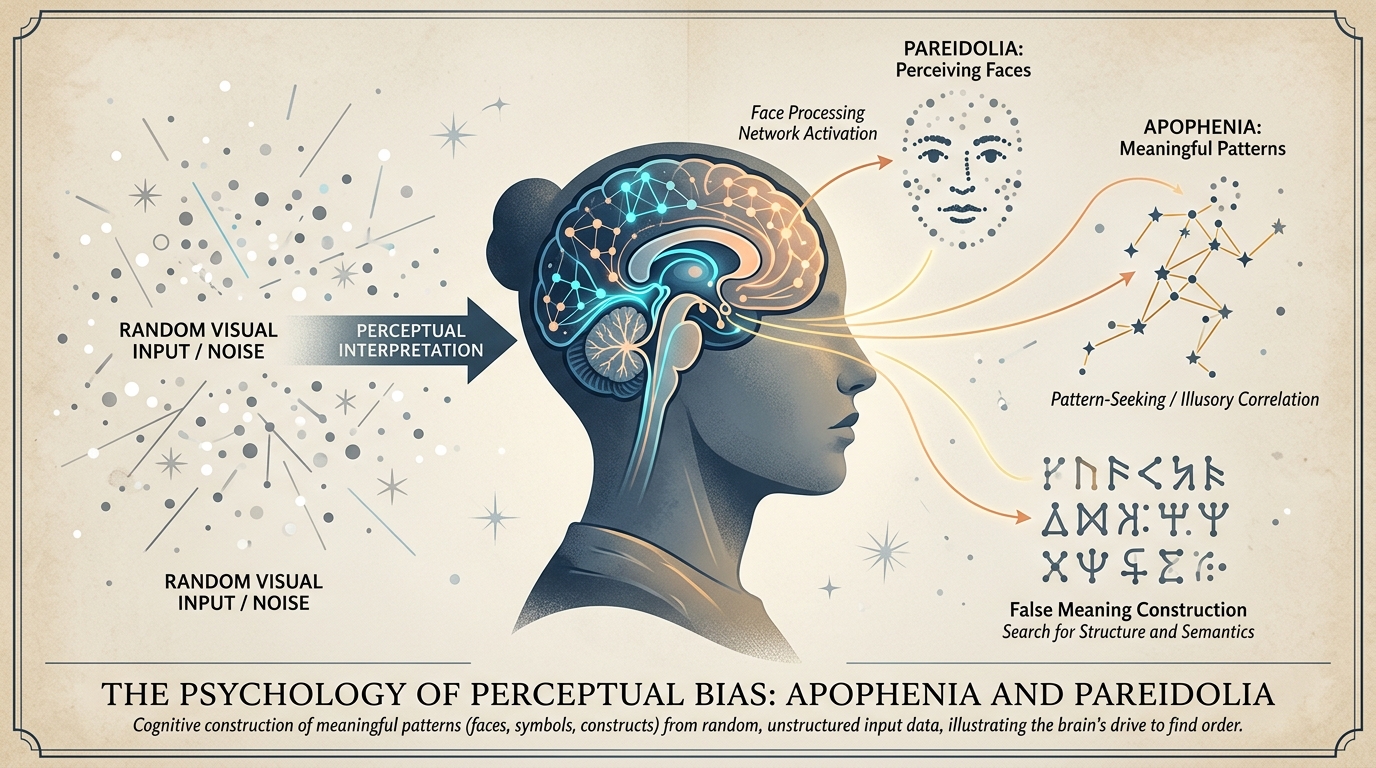
เหตุใดมนุษย์จึงมักปักใจเชื่อว่าข้อความที่อ่านไม่ออกนี้ต้องมีความหมายซ่อนอยู่? คำตอบทางจิตวิทยาและประสาทวิทยาศาสตร์ชี้ไปที่กลไกการทำงานของสมองที่เรียกว่า อาโปฟีเนีย (Apophenia) และ พาไรโดเลีย (Pareidolia)
ทำไมสมองมนุษย์ถึงถูกหลอกด้วยสถิติ?
ในทางวิวัฒนาการ สมองของบรรพบุรุษมนุษย์ถูกคัดเลือกให้ "มองหาความหมาย" (Pattern-Seeking) เพื่อเอาชีวิตรอด เช่น หากเราเห็นเงาตะคุ่มในพุ่มไม้ การทึกทักไว้ก่อนว่าเป็นเสือ (แม้จะเป็นแค่เงากิ่งไม้สุ่มๆ) ทำให้เรารอดชีวิต ดีกว่าการมองว่าเป็นเรื่องบังเอิญแล้วโดนเสือขย้ำ! ด้วยเหตุนี้ เมื่อสมองเผชิญกับข้อความที่มี "โครงสร้างสถิติเฉพาะตัว" สมองจะพยายามจับคู่ (Pattern Matching) เพื่อเติมเต็มความหมายโดยอัตโนมัติ ส่งผลให้ในอดีต มีนักวิจัยมากกว่า 50 คน อ้างว่าตนถอดรหัสวอยนิชได้แล้ว ทั้งเป็นภาษาฮีบรู, ละตินยุคกลาง, นาฮัวเติล (ของชาวแอซเท็ก), บาสก์, ทมิฬ หรือแม้แต่ภาษาของมนุษย์ต่างดาว ทว่าไม่มีใครถอดรหัสออกมาได้ตรงกันแม้แต่คนเดียว!
2 โครงสร้างสุ่มแบบมาร์คอฟและคณิตศาสตร์ความน่าจะเป็น (ม.5)
2.1 ปูพื้นฐาน: เหตุการณ์อิสระกับเหตุการณ์ที่มีเงื่อนไข
ในวิชาคณิตศาสตร์ระดับ ม.5 เรื่อง ความน่าจะเป็น (Probability) เราจำแนกประเภทของการสุ่มเหตุการณ์ออกเป็น 2 รูปแบบหลัก ซึ่งเปรียบได้กับการทอยลูกเต๋าและการจั่วไพ่:
การทอยลูกเต๋าแต่ละครั้งมีผลลัพธ์ที่เป็นอิสระต่อกัน ไม่ว่าจะทอยได้หน้า 6 มาแล้วสิบครั้งติดต่อกัน โอกาสที่ครั้งถัดไปจะได้หน้า 6 ก็ยังคงเป็น $\frac{1}{6}$ เท่าเดิมเสมอ เปรียบเสมือนการสุ่มตัวอักษรแบบใส่คืน (Sampling with replacement)
การจั่วไพ่จากสำรับโดยไม่ใส่คืน (Sampling without replacement) จำนวนไพ่จะลดลง ทำให้โอกาสเกิดเหตุการณ์ถัดไปขึ้นอยู่กับว่าในอดีตเราจั่วได้ใบใด นี่คือหัวใจของ ความน่าจะเป็นแบบมีเงื่อนไข (Conditional Probability)
2.2 กระบวนการมาร์คอฟ (Markov Chain): การสร้างภาษาด้วยความน่าจะเป็น
หากเรานำหลักการความน่าจะเป็นแบบมีเงื่อนไขมาสร้างสายโซ่ของตัวอักษร โดยกำหนดกฎว่า "สัญลักษณ์ถัดไปจะถูกกำหนดโดยสัญลักษณ์ในปัจจุบันเท่านั้น" ระบบนี้ในทางคณิตศาสตร์เรียกว่า กระบวนการมาร์คอฟ (Markov Process) ซึ่งคิดค้นโดยนักคณิตศาสตร์ชาวรัสเซีย อันเดรย์ มาร์คอฟ (Andrey Markov)
เราสามารถแทนโครงสร้างนี้ได้ด้วย เมทริกซ์การเปลี่ยนสถานะ (Transition Matrix: $\mathbf{P}$) ซึ่งเป็นเมทริกซ์สุ่ม (Stochastic Matrix) ที่ผลรวมของความน่าจะเป็นในแต่ละแถวต้องเท่ากับ $1$ เสมอ:
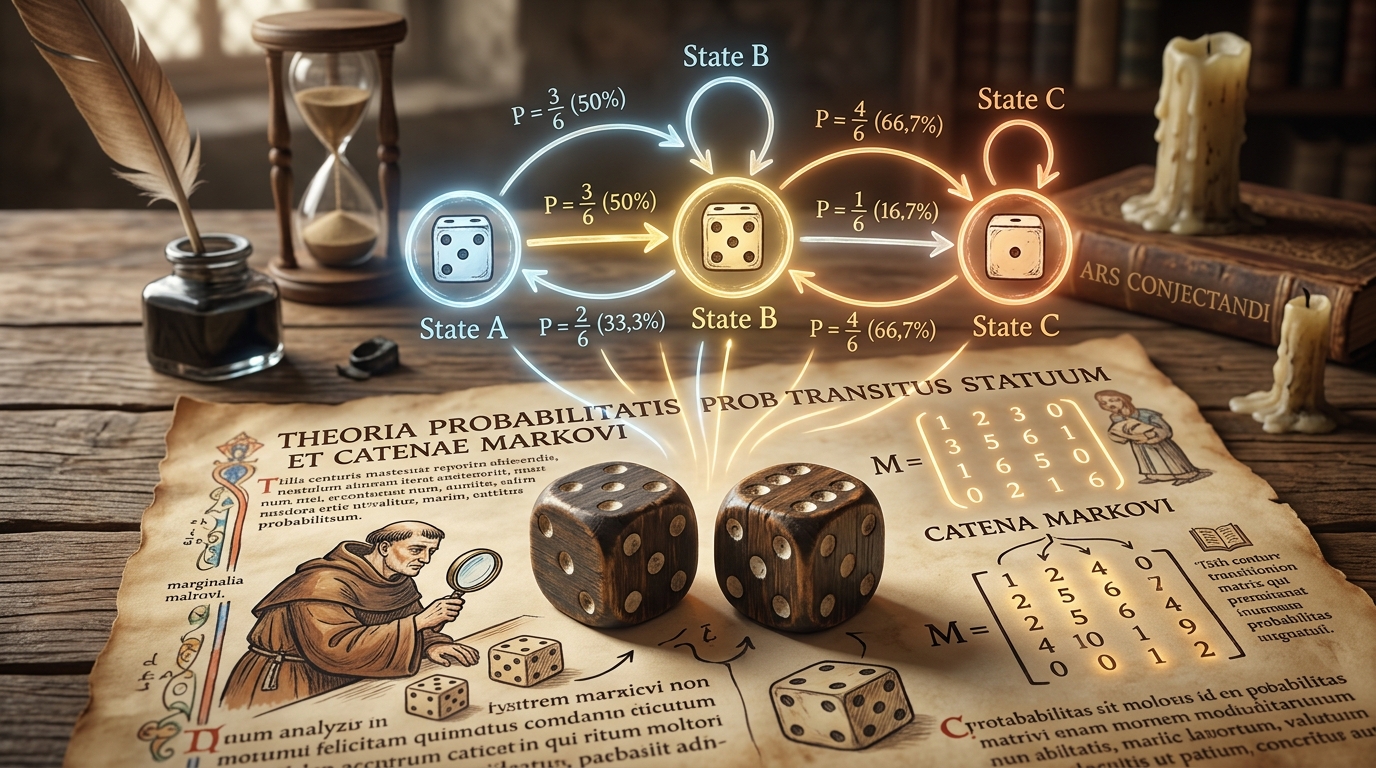
สมมติว่าเรามีสัญลักษณ์เพียง 5 ตัว ได้แก่ สระ $\{A, E\}$ และพยัญชนะ $\{K, P, T\}$ หากเราสุ่มตัวอักษรแบบอิสระเท่ากันทุกตัว (Uniform Random) เราอาจได้ข้อความประหลาดที่ออกเสียงไม่ได้ เช่น "kkptp" หรือ "eeaaa" แต่ถ้าเรากำหนดเมทริกซ์มาร์คอฟว่า:
- ถ้าสถานะปัจจุบันเป็น พยัญชนะ $\to$ โอกาสที่จะตามด้วย สระ สูงถึง $70\%$ ($P = 0.70$)
- ถ้าสถานะปัจจุบันเป็น สระ $\to$ โอกาสที่จะตามด้วย พยัญชนะ สูงถึง $80\%$ ($P = 0.80$)
เพียงแค่ใช้ลูกเต๋าถ่วงน้ำหนักตามตารางนี้ ลำดับตัวอักษรที่ผลิตออกมาจะกลายเป็นคำจำลอง (Pseudo-words) เช่น "pateka", "tepako", "kapeti" ทันที! มันให้ความรู้สึกเหมือนภาษาโบราณที่อ่านออกเสียงได้ ทั้งที่ไม่มีความหมายใดๆ แฝงอยู่เลยแม้แต่น้อย
2.3 สมมติฐานตะแกรงคาร์ดัน (The Cardan Grille Hypothesis)
ในศตวรรษที่ 15 ยังไม่มีคอมพิวเตอร์ แล้วผู้เขียนในยุคนั้นจะสร้างกระบวนการมาร์คอฟได้อย่างไร? ในปี ค.ศ. 2004 ดร. กอร์ดอน รักก์ (Dr. Gordon Rugg) นักวิทยาการคอมพิวเตอร์แห่งมหาวิทยาลัยคีล ได้เสนอทฤษฎีที่สร้างความสั่นสะเทือนแก่วงการ นั่นคือ "สมมติฐานตะแกรงคาร์ดัน" (Cardan Grille)
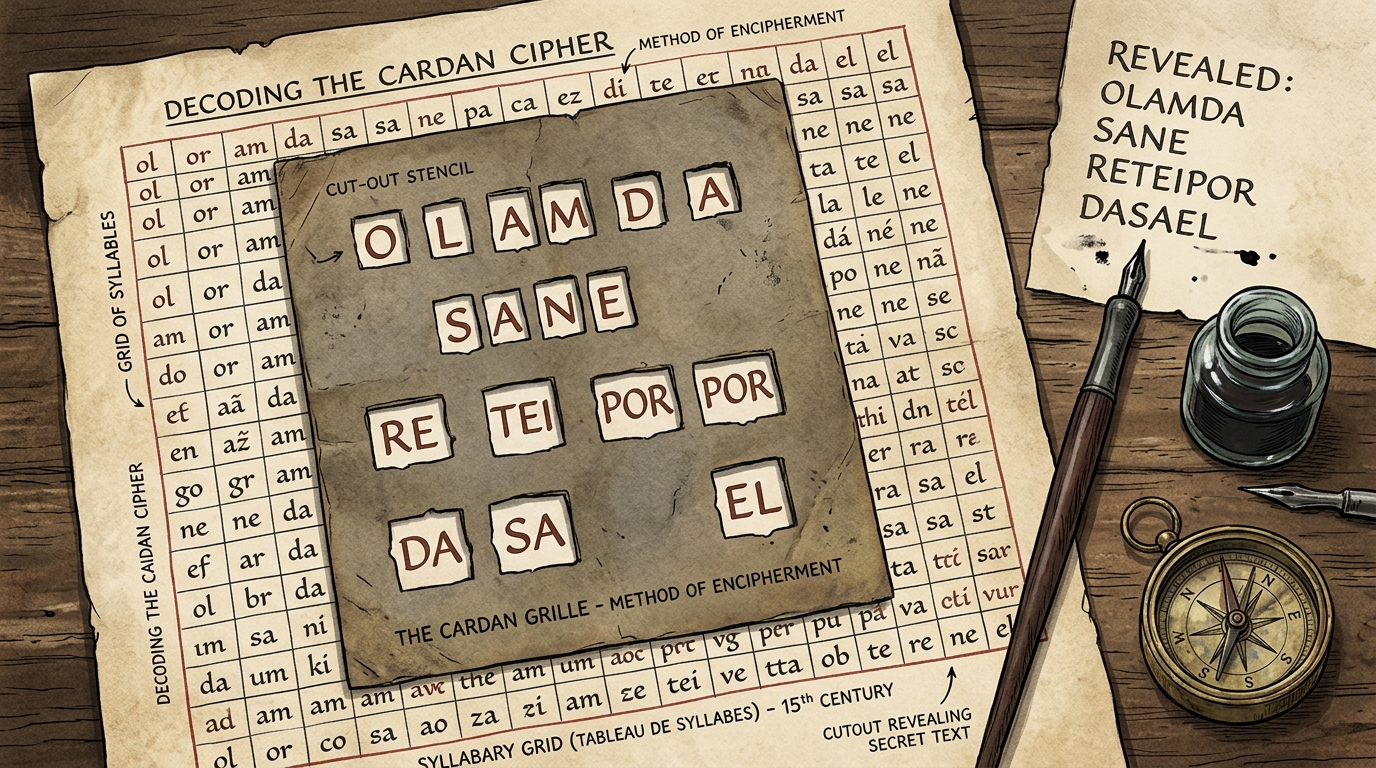
เจโรลาโม คาร์ดาโน (Girolamo Cardano) นักคณิตศาสตร์ชื่อดังในศตวรรษที่ 16 ได้ประดิษฐ์แผ่นกระดาษแข็งเจาะรูเพื่อใช้ส่งสารลับ รังค์ได้พิสูจน์ให้เห็นว่า หากนำแผ่นเจาะรูนี้มาทาบลงบน ตารางพยางค์ (Syllabary Grid) ที่แบ่งเป็นส่วนพยางค์ต้น (Prefix), พยางค์แกน (Root), และพยางค์ท้าย (Suffix) แล้วสุ่มเลื่อนแผ่นเจาะรูไปเรื่อยๆ:
ผลลัพธ์จากการทดลองของ Dr. Gordon Rugg
คนยุคกลางสามารถเขียนข้อความคล้ายวอยนิชได้เร็วถึง 1-2 หน้าต่อชั่วโมง โดยข้อความที่ได้จะมีคุณสมบัติทางสถิติตรงกับวอยนิชอย่างน่าทึ่ง ทั้งการกระจายตัวของคำตามกฎของซิปฟ์, อัตราเอนโทรปีที่ต่ำ, และปรากฏการณ์คำซ้ำซาก (Reduplication) ที่เกิดขึ้นเมื่อแผ่นเจาะรูเลื่อนไปตกที่ช่องเดิมซ้ำสองครั้ง!
3 ห้องทดลองจำลองมาร์คอฟ: สร้างภาษาปริศนาด้วยตัวคุณเอง 🎲
สัมผัสหลักการทำงานจริงของกระบวนการมาร์คอฟผ่าน Interactive Simulator ด้านล่างนี้ โดยระบบจะจำลองโหนดสถานะตัวอักษร 5 ตัว และมีอนุภาคแสงแสดงทิศทางการเปลี่ยนสถานะตามค่าน้ำหนักความน่าจะเป็นที่คุณสามารถปรับแต่งได้แบบเรียลไทม์
กิจกรรม Active Learning: ท้าทายความคิด พิชิตสถิติมาร์คอฟ!
ลองปรับแต่งค่าในแบบจำลองด้านบน แล้วตอบคำถามใน 3 ภารกิจต่อไปนี้:
สร้างคำสไตล์ภาษาธรรมชาติ
กดปุ่ม "ภาษาธรรมชาติ" (สระ $\to$ พยัญชนะ 0.80 และ พยัญชนะ $\to$ สระ 0.70)
สังเกตการทอยลูกเต๋า (Step)
กด "หยุดจำลอง" แล้วคลิก "ก้าวทีละขั้น (Step)" ติดต่อกัน 5-6 ครั้ง
ทดสอบการสุ่มเท่ากัน (Uniform)
กดปุ่ม "สุ่มเท่ากัน" (ปรับสไลเดอร์ทั้ง 4 ตัวไว้ที่ 0.50 เท่ากันทั้งหมด)
4 ทฤษฎีสารสนเทศและเอนโทรปีของแชนนอน (Information Theory & Shannon Entropy)
4.1 เอนโทรปีคืออะไร? มาตรวัดความไม่แน่นอนของข้อมูล
ในปี ค.ศ. 1948 โคลด แชนนอน (Claude Shannon) บิดาแห่งทฤษฎีสารสนเทศ ได้นิยามสมการทางคณิตศาสตร์เพื่อวัด "ระดับความไม่แน่นอน" หรือ "ปริมาณสารสนเทศเฉลี่ย" ที่แฝงอยู่ในลำดับข้อมูล เรียกว่า เอนโทรปีของแชนนอน (Shannon Entropy: $H(X)$):
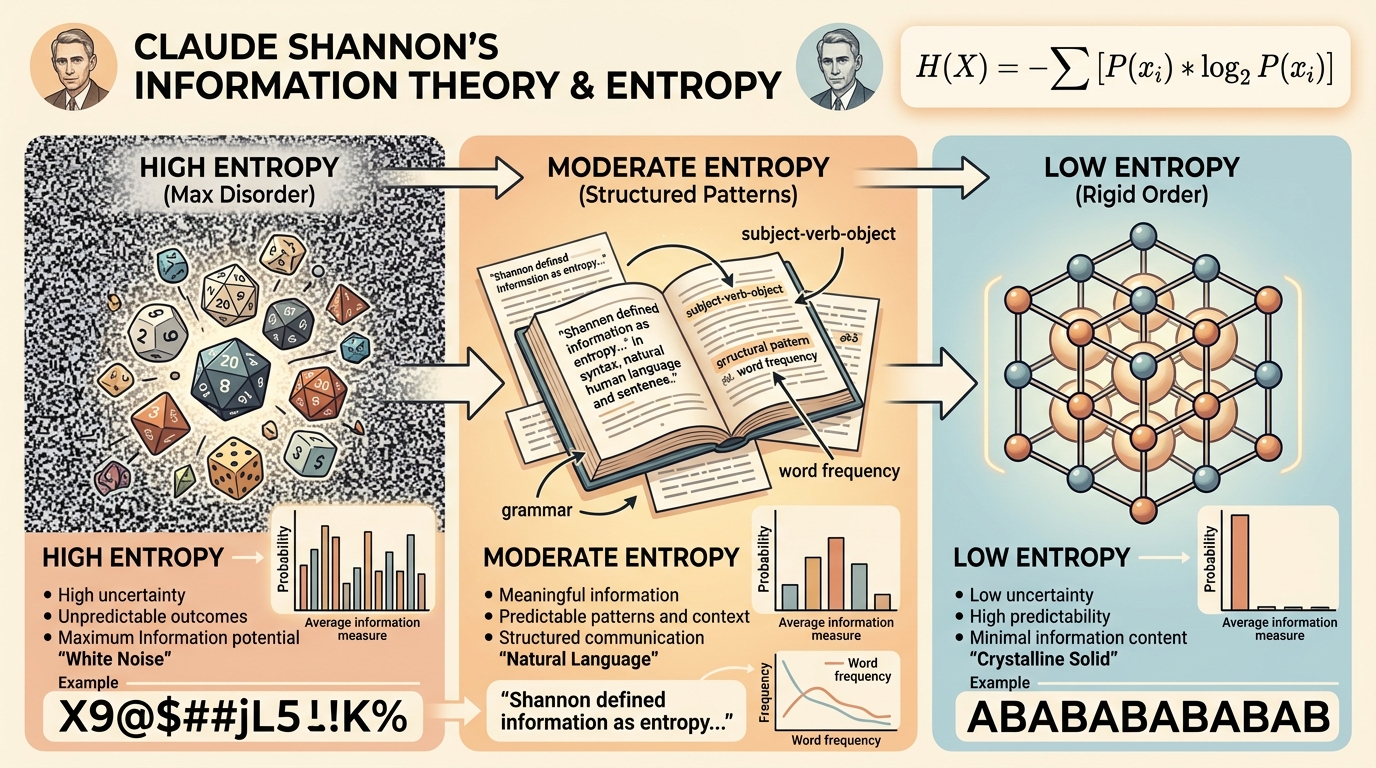
ค่าเอนโทรปีสะท้อนให้เห็นว่า ข้อความนั้น "คาดเดาได้ยากหรือง่ายเพียงใด":
4.2 ความผิดปกติของวอยนิช: ทำไมเอนโทรปีจึง "ต่ำเกินไป"?
เมื่อนักคณิตศาสตร์นำข้อความในต้นฉบับวอยนิชไปคำนวณเอนโทรปี พบผลลัพธ์ที่น่าประหลาดใจยิ่ง:
การค้นพบทางสถิติระดับโลก
เอนโทรปีของอักษรวอยนิชมีค่าเฉลี่ยเพียงประมาณ $3.5 - 3.8$ บิตต่ออักขระ ซึ่ง ต่ำกว่าภาษายุโรปทุกภาษาที่มนุษย์เคยใช้ และเมื่อคำนวณเอนโทรปีแบบมีเงื่อนไขอันดับสอง (Second-order Conditional Entropy: $H(X_2|X_1)$) ค่าเอนโทรปียิ่งลดฮวบลงอย่างรวดเร็ว บ่งชี้ว่า "เมื่อทราบตัวอักษรปัจจุบัน ตัวอักษรถัดไปจะถูกบังคับเกือบตายตัว" นี่คือหลักฐานเชิงประจักษ์ว่าข้อความนี้ถูกสร้างขึ้นด้วยกลไกเชิงกลหรือตารางสุ่มที่จำกัดทางเลือกอย่างเข้มงวด
4.3 สถิติท้องถิ่น (Local Statistics) vs ความหมายระยะไกล (Global Semantics)
กระบวนการมาร์คอฟทำหน้าที่เป็น "ตัวกรองเชิงสถิติ" (Statistical Filter):
- สถิติท้องถิ่น (Local Statistics): มาร์คอฟเชนอันดับ 1 หรือ 2 สามารถเลียนแบบความถี่ของพยางค์และคำ (Bigrams / Trigrams) ได้อย่างยอดเยี่ยม หลอกสายตามนุษย์ได้ในระดับสายตาที่กวาดมองผ่านๆ
- ความหมายระยะไกล (Global Semantics): ภาษาธรรมชาติของมนุษย์มีความสัมพันธ์ระยะยาวข้ามประโยคและย่อหน้า (Long-range correlation) เช่น การอ้างถึงประธานในบทที่ 1 หรือการโต้เถียงเชิงเหตุผล แต่มาร์คอฟเชนแบบลูกเต๋าไม่มีความทรงจำระยะไกล มันจึงไม่สามารถร้อยเรียง "สารสนเทศที่เป็นตรรกะ" ได้เลย
5 ห้องทดลองวิเคราะห์เอนโทรปีและกฎของซิปฟ์ (Interactive Entropy Lab) 🔬
ลองคลิกเลือกตัวอย่างข้อความ หรือพิมพ์/วางข้อความของคุณเอง เพื่อคำนวณค่าเอนโทรปีของแชนนอน ($H$) และตรวจสอบการแจกแจงความถี่ของตัวอักษรแบบสดๆ ทันที:
6 จากวอยนิชสู่ AI ยุคใหม่: โมเดลภาษาและการแจกแจงความน่าจะเป็น (ม.6)
6.1 กลไกการทำนายคำถัดไป (Next-Token Prediction)
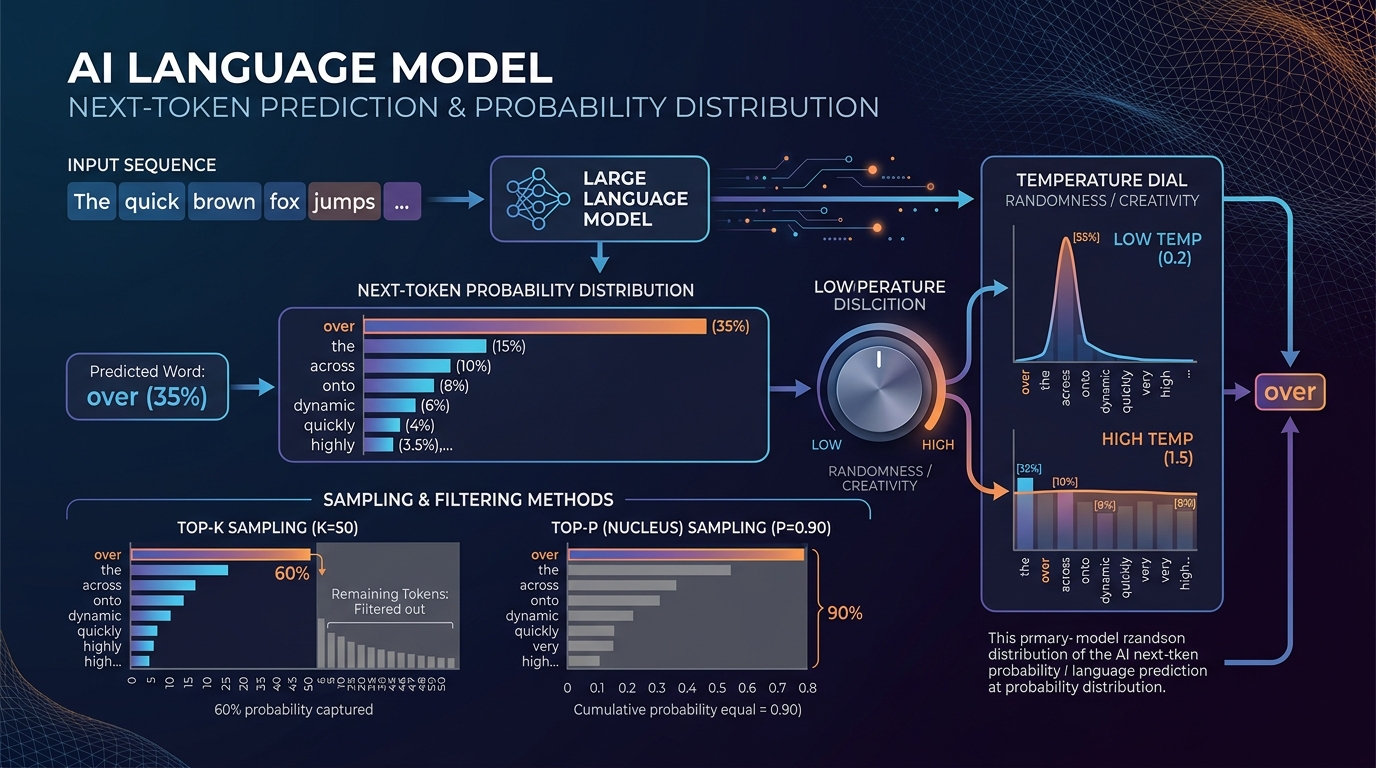
หลักการของมาร์คอฟเชนในศตวรรษที่ 15 ได้กลายเป็นรากฐานโดยตรงของโมเดลภาษาขนาดใหญ่ (Large Language Models เช่น ChatGPT, Claude, Gemini) ในศตวรรษที่ 21 โมเดลเหล่านี้ทำงานโดยการคำนวณ การแจกแจงความน่าจะเป็นของคำถัดไป (Probability Distribution over Vocabulary) ภายใต้บริบทของคำก่อนหน้าทั้งหมด:
6.2 พารามิเตอร์ควบคุมความน่าจะเป็นและตัวแปรสุ่ม (ม.6)
ในวิชาคณิตศาสตร์ ม.6 เรื่อง ตัวแปรสุ่มและการแจกแจงความน่าจะเป็น (Random Variables & Probability Distributions) เราเรียนรู้ว่าพฤติกรรมของการสุ่มสามารถถูกควบคุมได้ด้วยฟังก์ชันทางสถิติ ในโมเดลภาษา เราใช้พารามิเตอร์ต่อไปนี้ในการปรับแต่ง:
1. อุณหภูมิ (Temperature: $T$)
เป็นตัวแปรที่ใช้ปรับความชันของการแจกแจงความน่าจะเป็น:
- $T \to 0$ (Greedy Search / Low Entropy): โมเดลจะเลือกเฉพาะคำที่มีความน่าจะเป็นสูงสุดเสมอ คำตอบจะแม่นยำ ตายตัว และไม่มีความแปลกใหม่ (คล้ายผลึก)
- $T \approx 0.7$: ค่ามาตรฐานที่ให้ข้อความลื่นไหลเป็นธรรมชาติ มีความหลากหลายที่เหมาะสม
- $T > 1.2$ (High Entropy): ความน่าจะเป็นของแต่ละคำจะถูกเกลี่ยให้ใกล้เคียงกัน ทำให้โมเดลมีความคิดสร้างสรรค์สูง คาดเดาได้ยาก แต่อาจหลุดบริบทจนเพ้อเจ้อ
2. การสุ่มแบบ Top-K และ Top-P (Nucleus Sampling)
เป็นการตัดคำที่มีความน่าจะเป็นต่ำ (หางแถว) ทิ้ง เพื่อป้องกันไม่ให้โมเดลสร้างคำที่ไร้สาระ:
- Top-K: จำกัดตัวเลือกไว้เฉพาะกลุ่มคำที่มีความน่าจะเป็นสูงสุด $K$ อันดับแรก
- Top-P (Nucleus): เลือกคำจากกลุ่มย่อยที่มีผลรวมความน่าจะเป็นสะสม (Cumulative Probability) ถึงค่าที่กำหนด เช่น $90\%$ ($P = 0.90$)
6.3 ปรากฏการณ์ภาพหลอน (AI Hallucination) กับความจริงของข้อความวอยนิช
บทเรียนสำคัญจากสถิติสู่ความฉลาดประดิษฐ์
ทั้งกระบวนการมาร์คอฟและโมเดลภาษา AI มีจุดร่วมเดียวกันอย่างลึกซึ้ง: พวกมันสร้างข้อความขึ้นมาจากความน่าจะเป็นทางสถิติ ไม่ใช่จากความเข้าใจในความหมายที่แท้จริง หากปราศจากความรู้ที่เป็นจริง โมเดล AI จะสร้าง "ภาพหลอน" (Hallucination) ที่ใช้ไวยากรณ์สละสลวยน่าเชื่อถือแต่ไร้สาระ เช่นเดียวกับผู้เขียนต้นฉบับวอยนิชในยุคกลาง ที่สามารถใช้ลูกเต๋าและกระบวนการมาร์คอฟสร้างหนังสือหนา 240 หน้า ที่ดูคล้ายตำราแพทย์อันทรงคุณค่า เพื่อหลอกขายให้แก่จักรพรรดิรูดอล์ฟที่ 2 (Holy Roman Emperor Rudolf II) ในราคาสูงถึง 600 เหรียญทองคำดุกัต!
7 บทวิเคราะห์ทางวิชาการและบทสรุป: ภาษาลับ หรือกลลวงระดับประวัติศาสตร์?
ในแวดวงวิชาการปัจจุบัน นักวิจัยได้แบ่งทฤษฎีอธิบายต้นฉบับวอยนิชออกเป็น 3 แนวทางหลัก ซึ่งเราสามารถสรุปจุดแข็งและข้อจำกัดผ่านตารางเปรียบเทียบดังนี้:
| สมมติฐานทางวิชาการ | หลักฐานที่สนับสนุน | ข้อจำกัด / ข้อโต้แย้งทางสถิติ |
|---|---|---|
| 1. รหัสลับที่เข้ารหัสไว้ (Encrypted Ciphertext) | ผู้เขียนในยุคเรเนซองส์นิยมใช้รหัสเพื่อซ่อนสูตรเคมีและการเล่นแร่แปรธาตุ | รหัสลับส่วนใหญ่จะทำให้เอนโทรปีพุ่งสูงขึ้น (High Entropy) และทำลายกฎของซิปฟ์ แต่วอยนิชกลับมีเอนโทรปีต่ำผิดปกติ |
| 2. ภาษาธรรมชาติที่ไม่รู้จัก (Lost Natural Language) | เป็นไปตามกฎของซิปฟ์ (Zipf's Law) และการกระจายตัวของความยาวคำเหมือนภาษาจริง | มีการซ้ำคำติดๆ กัน (Reduplication) บ่อยเกินไป และมีโครงสร้างพยางค์ที่แข็งทื่อจนไม่สอดคล้องกับสัทศาสตร์ของมนุษย์ |
| 3. กลลวงสร้างด้วยขั้นตอนวิธี (Procedural Generation / Hoax) | การใช้ Cardan Grille หรือ Markov Table เลียนแบบสถิติของวอยนิชได้สมบูรณ์แบบ ทั้งค่าเอนโทรปี กฎของซิปฟ์ และคำซ้ำ | ผู้สร้างต้องใช้ความพยายามมหาศาลในการวาดภาพประกอบและเขียนหนังสือหนา 240 หน้าโดยไม่มีความหมายจริง |
คณิตศาสตร์คือแว่นขยายส่องหาความจริง ✨
ไม่ว่าต้นฉบับวอยนิชจะถูกเฉลยว่าเป็นบันทึกของแพทย์ยุคกลาง หรือเป็นเพียงกลลวงบันลือโลกที่สร้างด้วยลูกเต๋าและตารางพยางค์ สิ่งที่หนังสือเล่มนี้มอบให้แก่นักเรียนทุกคนคือ บทเรียนอันทรงคุณค่าว่าด้วย "พลังของสถิติและการคิดเชิงวิพากษ์" (Critical Thinking) ในโลกยุคปัจจุบันที่เต็มไปด้วยข้อมูลมหาศาลและโมเดล AI ที่เก่งกาจขึ้นทุกวัน การเข้าใจคณิตศาสตร์ความน่าจะเป็นและทฤษฎีสารสนเทศ คืออาวุธสำคัญที่จะช่วยให้เราแยกแยะความจริงออกจากภาพลวงตาได้เสมอครับ
สรุปสาระสำคัญสำหรับทบทวน (Math & AI Cheatsheet) 📚
Markov Property & Bigrams
กระบวนการมาร์คอฟกำหนดว่าสถานะถัดไปขึ้นกับสถานะปัจจุบันเท่านั้น ($P(X_{t+1}|X_t)$) การกำหนดความถี่ของคู่ตัวอักษรทำให้เกิดคำที่มีโครงสร้างพยางค์คล้ายภาษาจริง
Shannon Entropy ($H$)
วัดความไม่แน่นอนของข้อมูล วอยนิชมีเอนโทรปีต่ำ ($3.5 - 3.8$ บิต) บ่งชี้ว่าระบบถูกจำกัดกฎเกณฑ์ทางสถิติอย่างเข้มงวด ต่างจากภาษาธรรมชาติที่เอนโทรปีสูงกว่า
Next-Token Prediction & Softmax
โมเดลภาษาแปลง Logits เป็นความน่าจะเป็นสะสม โดยใช้ Temperature ควบคุมความแบนราบของการแจกแจง และใช้ Top-K / Top-P กรองหางแถวที่ไม่เกี่ยวข้อง
Apophenia & Hallucination
อาโปฟีเนียคือการที่สมองมนุษย์เชื่อมโยงหาความหมายในความสุ่ม สอดคล้องกับภาพหลอนของ AI ที่สร้างข้อความตามน้ำหนักสถิติโดยไม่มีความเข้าใจความจริง
เอกสารประกอบ: ถอดรหัสลับวอยนิชด้วยสถิติและ AI 📚
ศึกษาและทบทวนเนื้อหาบทเรียนเจาะลึกเกี่ยวกับคณิตศาสตร์ความน่าจะเป็น กระบวนการมาร์คอฟ เอนโทรปีของแชนนอน และโมเดลภาษา AI ได้จากสไลด์ประกอบการเรียนรู้ด้านล่างนี้
สไลด์บทเรียน: ถอดรหัสลับวอยนิชด้วยสถิติและ AI
PDF Documentเอกสารประกอบการเรียน
หน้าจอมือถืออาจจะเล็กเกินไปสำหรับการอ่านสไลด์ แนะนำให้เปิดอ่านแบบเต็มจอหรือดาวน์โหลดเก็บไว้เพื่อความสะดวก
ดาวน์โหลด / เปิดสไลด์ PDFอยากทดลองสำรวจปรากฏการณ์คณิตศาสตร์และ AI อื่นๆ เพิ่มเติม?
เรียนรู้คณิตศาสตร์ วิทยาศาสตร์ และ AI ผ่าน Interactive Simulation ที่เข้าใจง่าย สนุก และเห็นภาพชัดเจนกับ Panya AI Tutor ได้แล้ววันนี้!
ลองใช้งาน Panya AI Tutor ฟรี